MeCabは、日本語の形態素解析ツールであり、テキストデータを単語に分割し、品詞を識別するために使われます。これは自然言語処理(NLP)の分野でよく使われるツールで、特に日本語テキストの分析に用いられます。MeCabはオープンソースであり、多くのプラットフォームで利用可能です。今回はPythonでMeCabを使用する方法を解説します。
MeCabのインストール
まず、pipを用いてMeCabをインストールしましょう。mecab-python3をPythonで使用する際には、MeCab自体のインストールと辞書データが必要です。
# MeCabと辞書のインストール
pip install mecab-python3 unidic-lite
MeCabの使い方
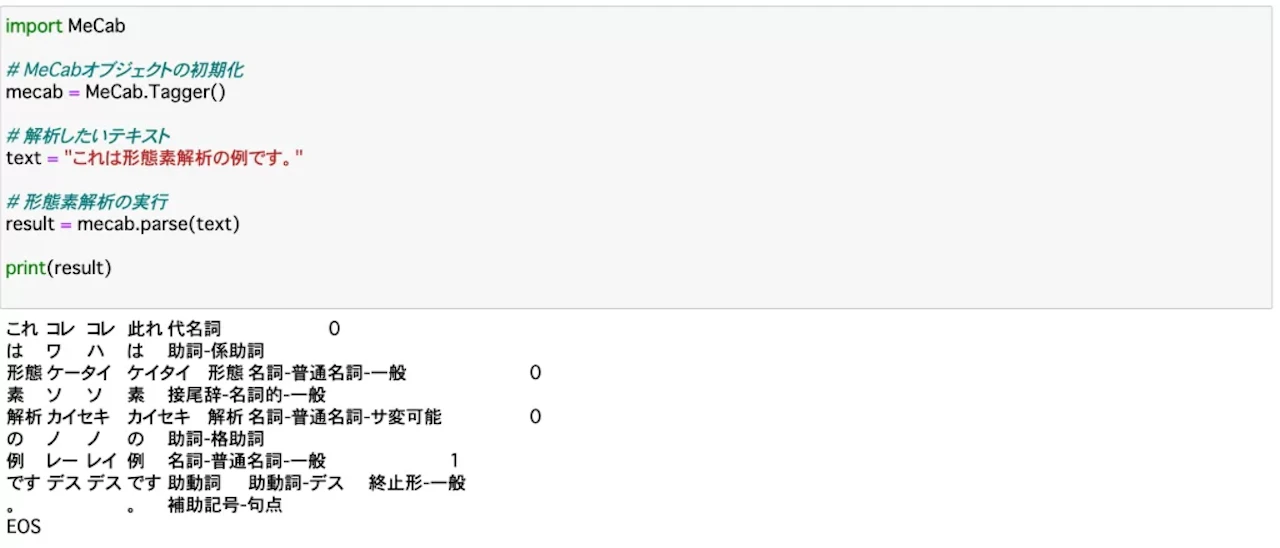
MeCabをインストールした後、Pythonから簡単に使用することができます。以下は、MeCabを使用してテキストを形態素解析する基本的な例です。
import MeCab

# MeCabオブジェクトの初期化
mecab = MeCab.Tagger()

# 解析したいテキスト
text = "これは形態素解析の例です。"

# 形態素解析の実行
result = mecab.parse(text)

print(result)
このスクリプトは、指定したテキストを形態素に分解し、各形態素の基本形、品詞などの情報を表示します。実行結果は次のようになります。
さらにMeCabを使いこなす
さて、もう少し高度なMeCabの使い方を解説します。あるテキストデータから、名詞の単語だけ抽出するコードを書いてましょう。
import MeCab

# MeCabの初期化
mecab = MeCab.Tagger()

# 解析したいテキストデータ
text = """
日本経済新聞で面白い記事を読みました。AIに関する最新の研究成果が紹介されており、
非常に興味深い内容でした。技術の進歩は日々加速しているようです。
"""

# 特定の品詞を検索する関数
def search_words_by_pos(text, pos_to_search):
    words_found = []

    # テキストを形態素解析
    node = mecab.parseToNode(text)

    # ノードを走査
    while node:
        # 品詞情報の取得
        pos = node.feature.split(",")[0]
        # 指定した品詞に一致する場合は、単語をリストに追加
        if pos == pos_to_search:
            word = node.surface
            words_found.append(word)
        node = node.next

    return words_found

# 名詞を検索
nouns = search_words_by_pos(text, "名詞")

print("見つかった名詞:", nouns)
このコードを実行すると、次のような出力結果が得られます。
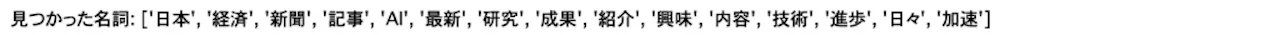
まとめ
わずかなPythonコードで形態素解析ができるMeCabの面白さを実感していただけましたか?今後本格的に使用される場合は以下のことに留意してください
- MeCabのバージョンやインストールした辞書によって、出力結果が異なる場合がある。
- MeCabは非常に高速で正確な形態素解析を提供するが、専門的な用語や新しい言葉には対応していない場合がある。これらの場合、カスタム辞書を追加することで解決できることがある。
MeCabのような形態素解析は、辞書やバージョンの違いで結果が変わるため、Pythonの基礎が固まっているほど扱いやすくなります。基礎から順に積み上げたい方に向けたスクールとしてSiiDを運営しています。
AIプログラミングスクール「SiiD」について
AIプログラミングスクール「SiiD」は、未経験からITエンジニア転職を目指す方向けのオンラインスクールです。
SiiDの特徴
- 現役エンジニアでYouTube登録者約13万人の「セイト先生」が代表兼主任講師
- 採用側の実務知見(2,000人以上の選考・150名以上のエンジニア採用)にもとづく指導
- 生成AIを取り入れた学習設計と、実務レベルのフルスタックWeb開発スキル
- Workship CAREER(株式会社GIG)と連携した無料の転職伴走支援
- 経済産業省認定のReスキル講座で、給付金の条件を満たせば実質105,600円〜
- 学割あり(35%オフ)
こんな方におすすめ
- 未経験・文系・社会人からITエンジニア転職を本気で目指したい方
- 独学に限界を感じている方
- 費用を抑えながら実務スキルと転職サポートを両立したい方
「未経験だから」とあきらめる必要はありません。採用する側を知り尽くしたプロが、給付金で負担を抑えながら内定まで伴走します。